Chandra 2: AI, който извлича от PDF не само буквите, а и структурата
Chandra 2 извлича текст, таблици и ръкопис от PDF и снимки. Как да го пробваш и какво да провериш за цена, лиценз и точност.
Всеки, който е копирал текст от сканиран отчет, познава проблема: колоните се смесват, таблицата се разпада, а част от числата изчезват. При ръкописни бележки задачата става още по-трудна. Нужен е не просто списък от разпознати букви, а резултат, който запазва връзките между тях.
Chandra 2 на Datalab е модел за оптично разпознаване на текст — OCR. Според документацията той преобразува изображения и PDF документи в структуриран HTML, Markdown или JSON, като запазва информация за разположението на съдържанието. Това включва таблици, формуляри, математически изрази, ръкопис и изображения с описания.
Това не е новина за току-що пуснат модел: Chandra 2 е представен през март 2026 г. Поводът да го покажем е конкретният начин на работа с трудни документи.
Какво се вижда в примера
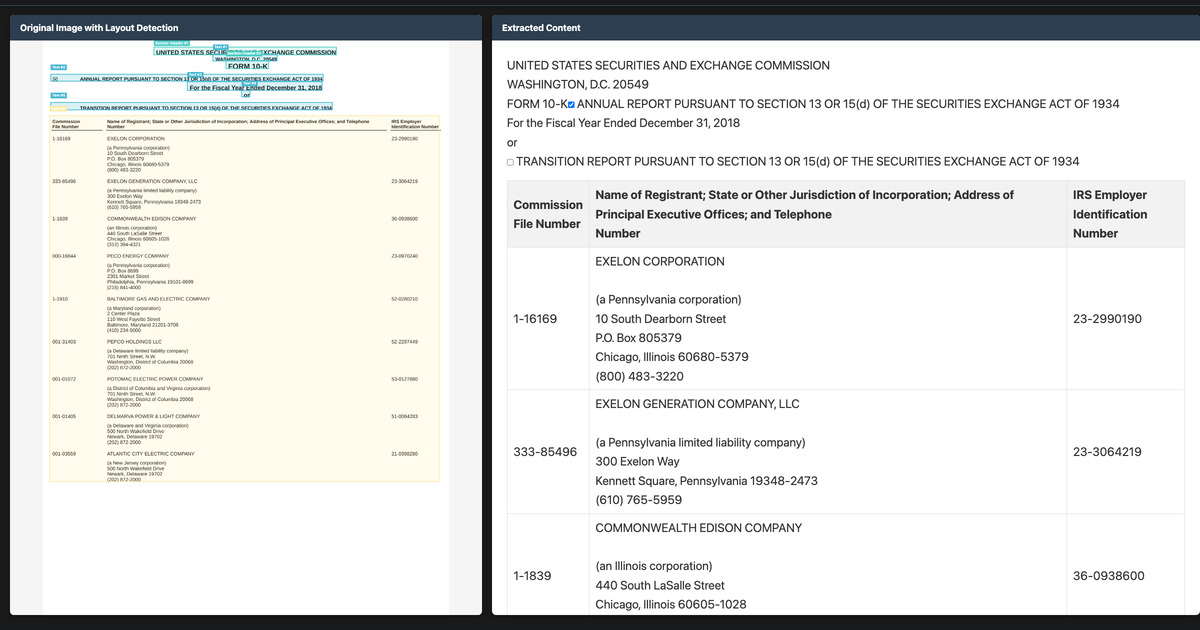
В демонстрационното видео на Datalab документът е отляво, а извлеченото съдържание — отдясно. Виждат се ръкописни страници, математически записки и отделена диаграма. Цветните области показват различни части от документа. Официалният пример с отчет показва и извлечена таблица, запазена като таблица, а не като дълъг ред от несвързани думи.
Това са демонстрации от източниците, не наш собствен тест. Видеото е на облачния интерфейс Datalab и не доказва, че всяка показана операция използва точно публичните тегла на Chandra 2. Самият разработчик посочва, че управляваната му услуга използва подобрена версия. Затова не трябва да очакваме непременно идентичен резултат от локалната инсталация.
Как да го пробваш разумно
1. Избери една страница без лични данни или фирмени тайни — например публичен отчет или свои несекретни записки. 2. Отвори Datalab Playground и използвай наличния начин за зареждане на документ. Не започвай с цял архив. 3. Сравни оригинала и извлеченото съдържание. Обърни специално внимание на десетични знаци, отрицателни стойности, отметки и разместване на колони. 4. Едва след проверката използвай резултата за търсене, обобщаване или следваща обработка.
За счетоводни и правни документи извличането е подготвителна стъпка, не основание за автоматично приемане на числата и условията. При чувствителни файлове първо се проверяват правилата за обработка на данни и подходящото място за изпълнение.
Безплатно ли е?
Към проверката на 7 септември 2026 г. живата ценова страница на Datalab предлага Free план с месечен лимит: 20 долара включено потребление за служебен имейл или 10 долара за личен. Не е нужна карта за използването на този лимит; за продължаване след него се включва платено потребление. Различните обработващи операции имат отделни цени, а изпълнението в ЕС е с доплащане. Това не е неограничен безплатен OCR.
Локалният вариант е отделна история. Кодът е под Apache 2.0, но теглата са с модифициран OpenRAIL-M лиценз и ограничения за употреба. Документацията описва безплатна употреба за изследвания, лични проекти и определени малки компании, както и забрана за конкурентна употреба спрямо API. За по-широка търговска употреба е нужна проверка на лиценза. Освен това локалната инсталация изисква техническа настройка и подходящ изчислителен ресурс.
А на български?
Българският присъства в публикуваната многоезична оценка на разработчика. Това е полезен ориентир, но не доказва точността върху твоите фактури, старите ти сканове или конкретен почерк. Не сме изпълнявали собствен тест на български.
Най-смисленият първи експеримент е малък: една трудна страница, ясен критерий за успех и проверка ред по ред. Ако резултатът е добър, вече има основание да мислиш за по-голям работен процес.